

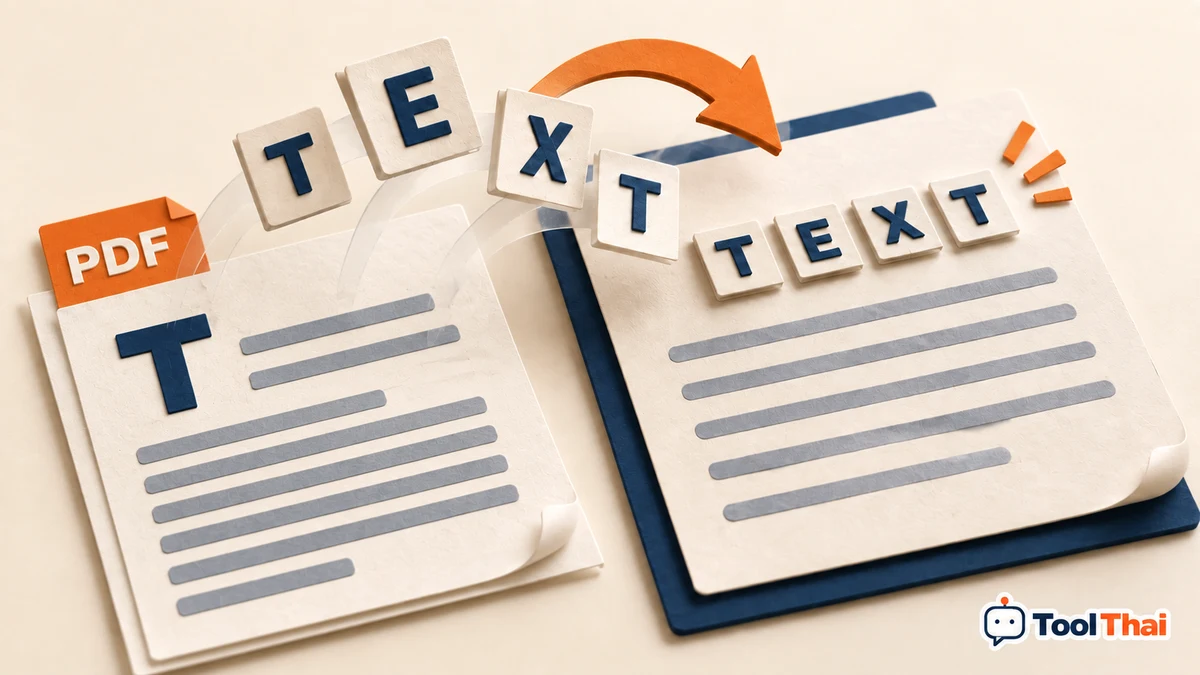
ดึงข้อความจาก PDF เป็น TXT
ดึงข้อความจาก PDF เป็น TXT — ไม่ทำ OCR หากหน้ามีแต่ภาพจะแจ้งว่าไม่พบข้อความ ลำดับคอลัมน์/วรรณยุกต์ขึ้นกับโครงสร้างต้นฉบับ
ดึงข้อความจาก PDF เป็น TXT
กรอกข้อมูลหรือเลือกไฟล์ แล้วกดประมวลผล
Result
ผลลัพธ์การคำนวณ
กรอกข้อมูลแล้วกดคำนวณ เพื่อดูผลลัพธ์และรายละเอียดที่นี่
วิธีใช้และการอ่านผล
ดึงชั้นข้อความจาก PDF เพื่อนำไปค้นหา คัดลอกหรือจัดรูปแบบต่อ
กรอกข้อมูลอย่างไร
ลองหน้าที่มีข้อความเลือกได้ก่อน ตรวจลำดับย่อหน้า ตารางและภาษาไทยกับภาพต้นฉบับ
อ่านผลและข้อจำกัด
ไม่ทำ OCR ให้หน้าสแกน และลำดับคอลัมน์หรือสระไทยอาจต่างจากการอ่านด้วยตา ต้องตรวจแก้ก่อนนำไปอ้างอิง
ไม่ทำ OCR หากหน้ามีแต่ภาพจะแจ้งว่าไม่พบข้อความ ลำดับคอลัมน์/วรรณยุกต์ขึ้นกับโครงสร้างต้นฉบับ
หลักการทำงาน
ตัวอย่างการใช้งาน
PDF ที่มีคำว่า ToolThai จะได้ข้อความ ToolThai ใน TXT
PDF สแกนอาจแสดงหน้าชัดแต่ดึงข้อความไม่ได้ ส่วน PDF สองคอลัมน์อาจได้บรรทัดสลับกัน
คำถามที่พบบ่อย
คำถามที่พบบ่อยเกี่ยวกับ ดึงข้อความจาก PDF เป็น TXT
เลือกข้อความได้หรือเป็นเพียงภาพถ่าย หมายถึงอะไร?
หน้าที่เห็นตัวหนังสือไม่ได้แปลว่ามี text layer เสมอไป เอกสารสแกนอาจมีแต่พิกเซล ส่วน PDF ที่มีข้อความจริงก็อาจเก็บชิ้นข้อความคนละลำดับกับที่สายตาอ่าน เครื่องมือจึงไม่ควรใช้ยืนยันข้อมูลสำคัญโดยไม่เทียบต้นฉบับ
ทดลองแล้วควรได้ผลอย่างไร?
PDF ที่มีคำว่า ToolThai จะได้ข้อความ ToolThai ใน TXT
มีข้อจำกัดอะไรที่ต้องตรวจ?
ไม่ทำ OCR หากหน้ามีแต่ภาพจะแจ้งว่าไม่พบข้อความ ลำดับคอลัมน์/วรรณยุกต์ขึ้นกับโครงสร้างต้นฉบับ
เครื่องมือที่เกี่ยวข้อง
แนะนำอัตโนมัติจากหมวดหมู่และ Tags ที่เกี่ยวข้อง
เพิ่มข้อความและคำอธิบายบน PDF
เพิ่มข้อความและคำอธิบายบน PDF — PDF ไม่เกิน 100 หน้า ข้อความไม่เกิน 1,000 ตัวอักษร ไม่รองรับข้อความเกินขอบหน้าและ PDF ที่หมุนหน้า; อาจทำให้ลายเซ็นดิจิทัลเดิมใช้ไม่ได้
ใส่เลขหน้าใน PDF
ใส่เลขหน้าใน PDF — ไม่เกิน 100 หน้า ไม่รองรับ PDF เข้ารหัสหรือหมุนหน้า รูปแบบตัวหารคือจำนวนหน้าที่ใส่เลข ไม่ใช่เลขสุดท้าย
ใส่ลายน้ำข้อความหรือรูปภาพบน PDF
ใส่ลายน้ำข้อความหรือรูปภาพบน PDF — ลายน้ำไม่ป้องกันการคัดลอก ไม่ใช้แทนการลบข้อมูลลับ เลือกตำแหน่งให้ภาพและข้อความไม่ล้นขอบ ไม่รองรับหน้าหมุน
บทความ คู่มือ และคำศัพท์ที่เกี่ยวข้อง
อ่านต่อเพื่อเข้าใจสูตร กรอกข้อมูล และใช้ผลลัพธ์ได้อย่างมั่นใจขึ้น
 บทความ
ดึงข้อความจาก PDF เป็น TXT: เลือกข้อความได้หรือเป็นเพียงภาพถ่าย
หน้าที่เห็นตัวหนังสือไม่ได้แปลว่ามี text layer เสมอไป เอกสารสแกนอาจมีแต่พิกเซล ส่วน PDF ที่มีข้อความจริงก็อาจเก็บชิ้นข้อความคนละลำดับกับที่สายตาอ่าน เครื่องมือจึงไม่ควรใช้ยืนยันข้อมูลสำคัญโดยไม่เทียบต้นฉบับ
 คู่มือ
วิธีใช้ดึงข้อความจาก PDF เป็น TXT
ทดลองหน้า 1 ก่อน หากได้ข้อความให้ตรวจชื่อ ตัวเลข และลำดับคอลัมน์ ถ้าแจ้งไม่พบข้อความ ให้ใช้เครื่องมือ OCR แยกต่างหาก ไม่ควรส่ง TXT ว่างเป็นเอกสารฉบับสมบูรณ์
ช่วยเราปรับปรุง ดึงข้อความจาก PDF เป็น TXT
พบปัญหาหรืออยากแนะนำอะไร ส่งความคิดเห็นให้ทีม ToolThai ได้โดยตรง